
설문조사가 끝나고
엑셀 파일을 열어보니
응답자가 300명이나 됩니다.
그런데 데이터를 정리하다 보니
빈칸이 있는 응답도 있고,
다른 응답자와 유난히
차이가 큰 숫자도 발견됩니다.
이럴 때 가장 먼저 드는 생각은
해당 데이터를 삭제해도
괜찮을지에 대한 고민입니다.
논문 데이터 분석에서는
분석 프로그램을 실행하기 전에
자료의 상태를 파악하는
과정이 중요한데요.
특히 결측치와 이상치를
어떻게 다루느냐에 따라
최종 분석 결과가 달라질 수 있습니다.
우선 결측치가 무엇인지
정확하게 구분해 볼 필요가 있습니다.
결측치는 수집한 데이터에서
관측값이 존재하지 않거나
기록되지 않은 상태를 의미합니다.
예를 들어 설문지의
특정 질문에 응답하지 않았거나,
검사 결과가 누락된 경우가
이에 해당할 수 있습니다.
중요한 것은 빈칸이 생긴
이유를 생각해 보는 일입니다.
단순한 입력 누락인지,
응답자가 의도적으로
답변하지 않은 것인지에 따라
자료의 특성이 달라질 수 있기 때문입니다.
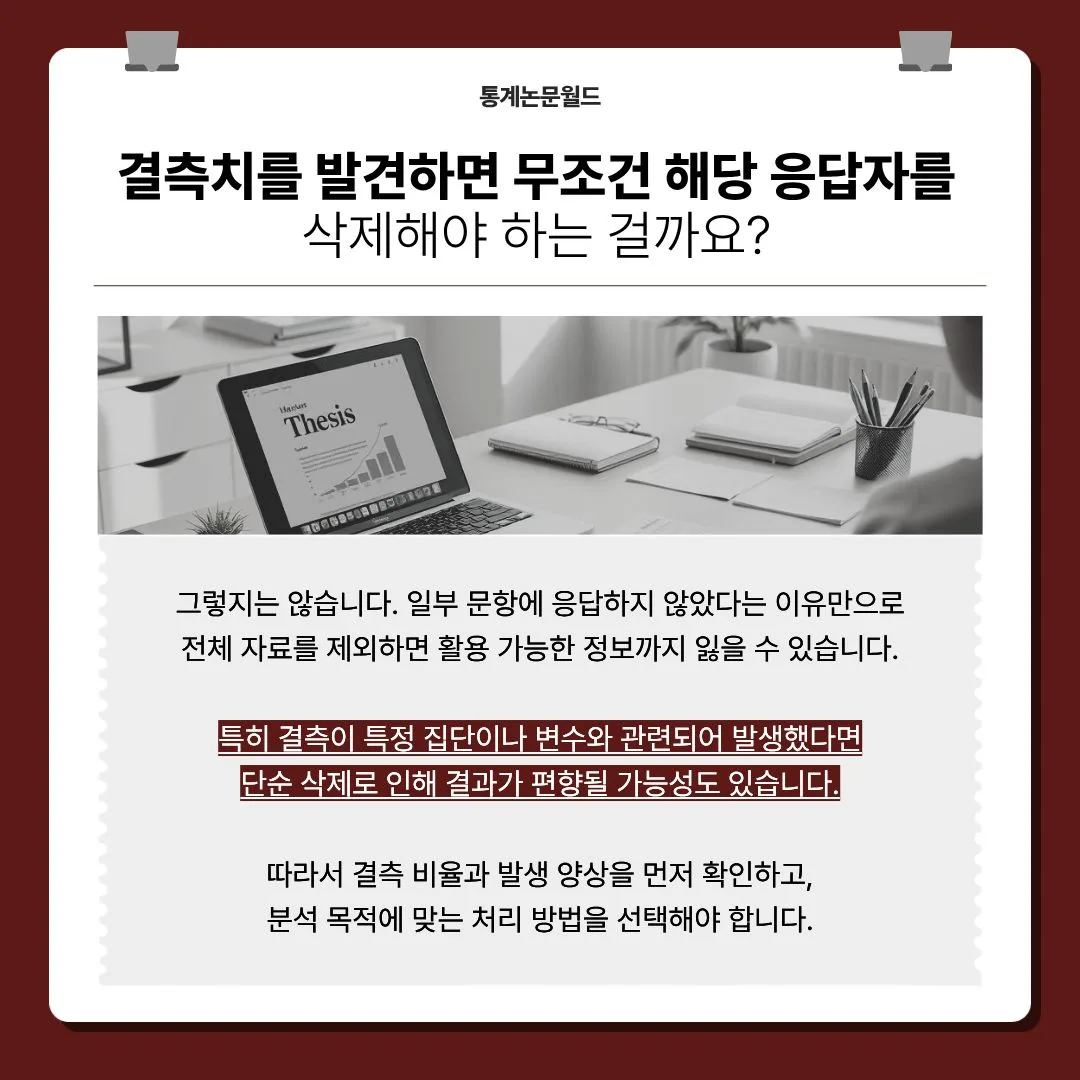
결측치를 발견하면
무조건 해당 응답자를
삭제해야 하는 걸까요?
그렇지는 않습니다.
일부 문항에 응답하지 않았다는
이유만으로 전체 자료를
제외하면 활용 가능한
정보까지 잃을 수 있습니다.
특히 결측이 특정 집단이나
변수와 관련되어 발생했다면
단순 삭제로 인해
결과가 편향될 가능성도 있습니다.
따라서 결측 비율과
발생 양상을 먼저 확인하고,
분석 목적에 맞는 처리 방법을
선택해야 합니다.
결측치 처리 방법에는
여러 가지가 있습니다.
결측이 포함된 사례를
제외하는 완전사례분석부터
다중대체법과 같은
통계적 방법까지 다양합니다.
다중대체법은 관측된 자료의
정보를 활용해 결측값을
여러 번 대체하고,
분석 결과를 결합하는 방식입니다.
다만 어떤 방법이 적절한지는
결측 발생 원인에 관한 가정과
자료의 특성에 따라 달라집니다.
결측값을 단순히 평균으로
채우는 방식은 변동성과
변수 간 관계를 왜곡할 수 있어
주의가 필요합니다.
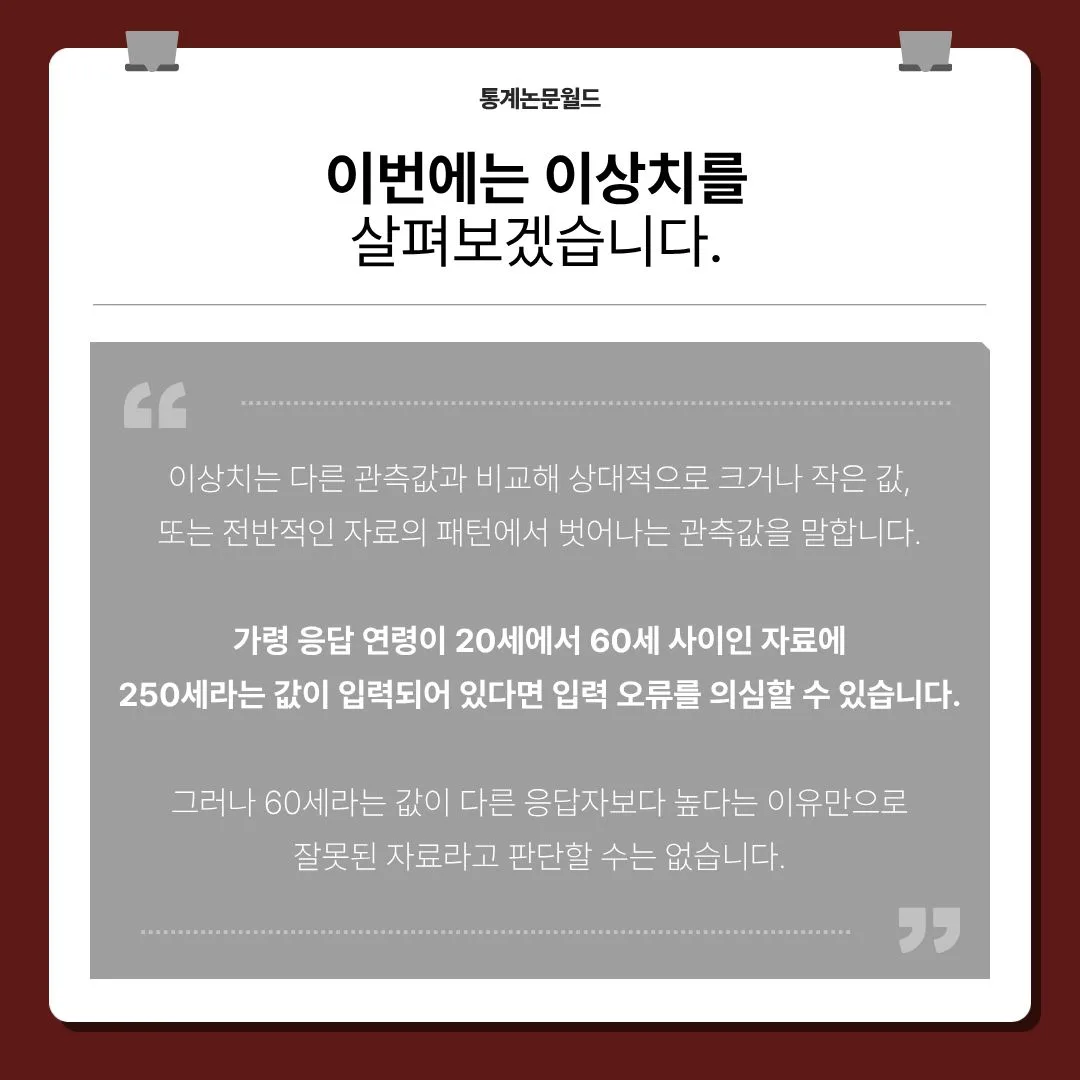
이번에는 이상치를 살펴보겠습니다.
이상치는 다른 관측값과 비교해
상대적으로 크거나 작은 값,
또는 전반적인 자료의 패턴에서
벗어나는 관측값을 말합니다.
가령 응답 연령이
20세에서 60세 사이인 자료에
250세라는 값이 입력되어 있다면
입력 오류를 의심할 수 있습니다.
그러나 60세라는 값이
다른 응답자보다 높다는 이유만으로
잘못된 자료라고
판단할 수는 없습니다.
이상치는 오류일 수도 있지만
실제로 존재하는
특이한 관측값일 수도 있습니다.
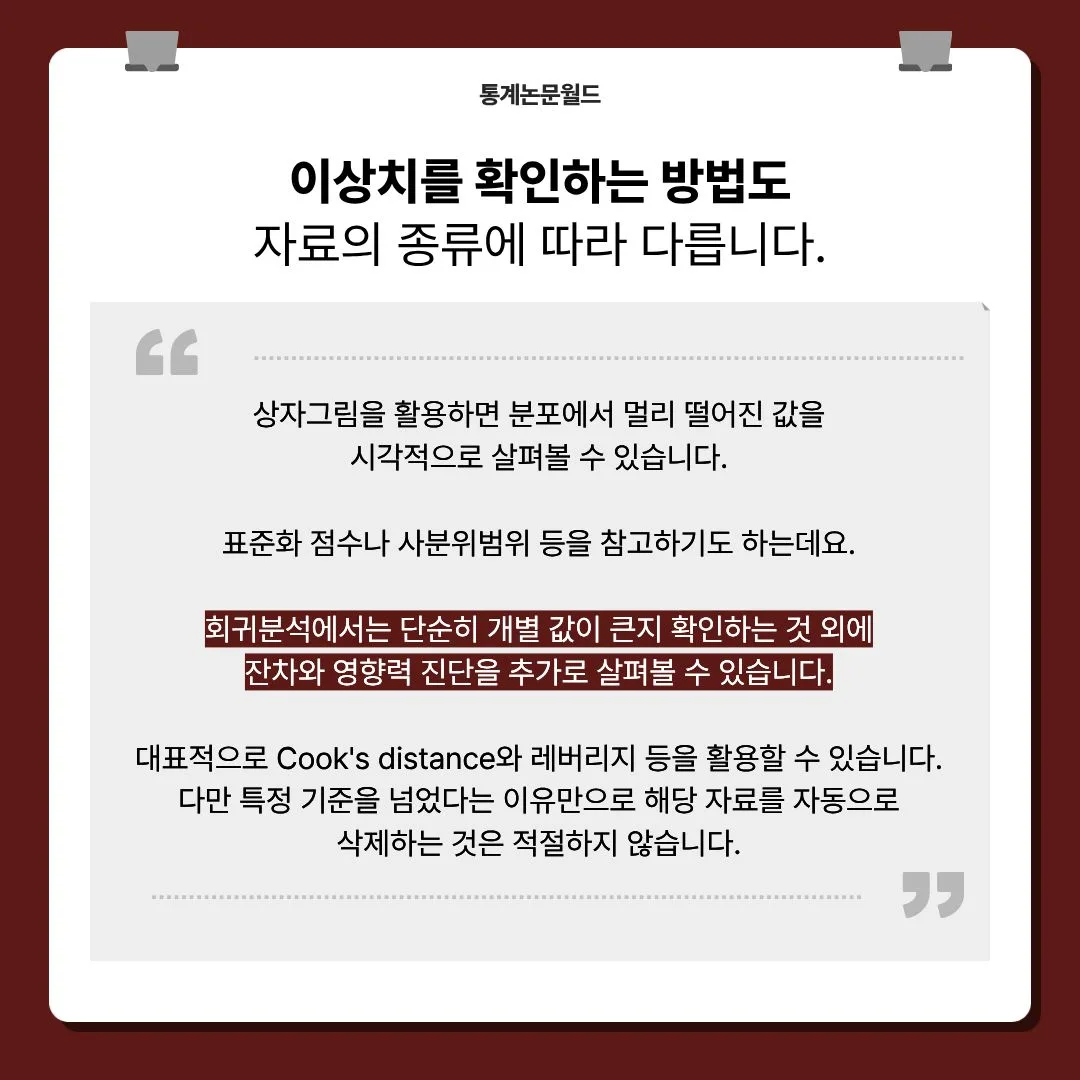
이상치를 확인하는 방법도
자료의 종류에 따라 다릅니다.
상자그림을 활용하면
분포에서 멀리 떨어진 값을
시각적으로 살펴볼 수 있습니다.
표준화 점수나 사분위범위 등을
참고하기도 하는데요.
회귀분석에서는 단순히
개별 값이 큰지 확인하는 것 외에
잔차와 영향력 진단을
추가로 살펴볼 수 있습니다.
대표적으로 Cook's distance와
레버리지 등을 활용할 수 있습니다.
다만 특정 기준을 넘었다는 이유만으로
해당 자료를 자동으로
삭제하는 것은 적절하지 않습니다.
이상치를 발견했다면
우선 원자료와 비교해
입력 오류 여부를 확인해야 합니다.
입력 과정에서 소수점이
잘못 표시되었거나
숫자가 중복 입력되었다면
근거에 따라 수정할 수 있습니다.
반면 실제 조사에서
확인된 값이라면
삭제 여부를 신중하게
검토해야 합니다.
필요에 따라 해당 관측값을
포함한 분석과 제외한 분석을
비교하는 민감도 분석을
진행할 수도 있습니다.
중요한 것은 연구자가
결과를 좋게 만들기 위해
자료를 임의로 수정하지 않는 것입니다.
데이터 정제 과정은
분석 결과를 해석할 때도
중요한 근거가 됩니다.
예를 들어 처음 수집한
자료가 300건이었다면
실제 분석에 사용한 자료가
몇 건인지 명확하게 밝혀야 합니다.
일부 자료를 제외했다면
제외 기준과 이유를
함께 기록하는 것이 좋습니다.
또한 결측치 처리 방법과
이상치 검토 기준도
논문에 설명할 필요가 있습니다.
이러한 정보가 있어야
다른 연구자가 분석 과정을
이해하고 결과의 신뢰성을
평가하는 데 도움이 됩니다.
논문 데이터 분석을 준비할 때는
자료를 정리한 방식까지
체계적으로 관리하는 것이 좋습니다.
원본 데이터는 별도로 보관하고,
수정한 항목과 처리 기준을
기록해 두는 방법이 유용합니다.
특히 여러 사람이 분석에
참여하는 연구라면
변수명과 코딩 기준을
공유하는 과정도 중요합니다.
통계논문월드는 석사·박사
학위논문 연구자를 대상으로
통계분석과 연구 컨설팅을
주요 서비스로 안내하고 있습니다.
결측치나 이상치 처리에
어려움을 겪고 있다면
자료의 특성과 연구설계에 맞는
분석 방향을 검토해 볼 수 있습니다.
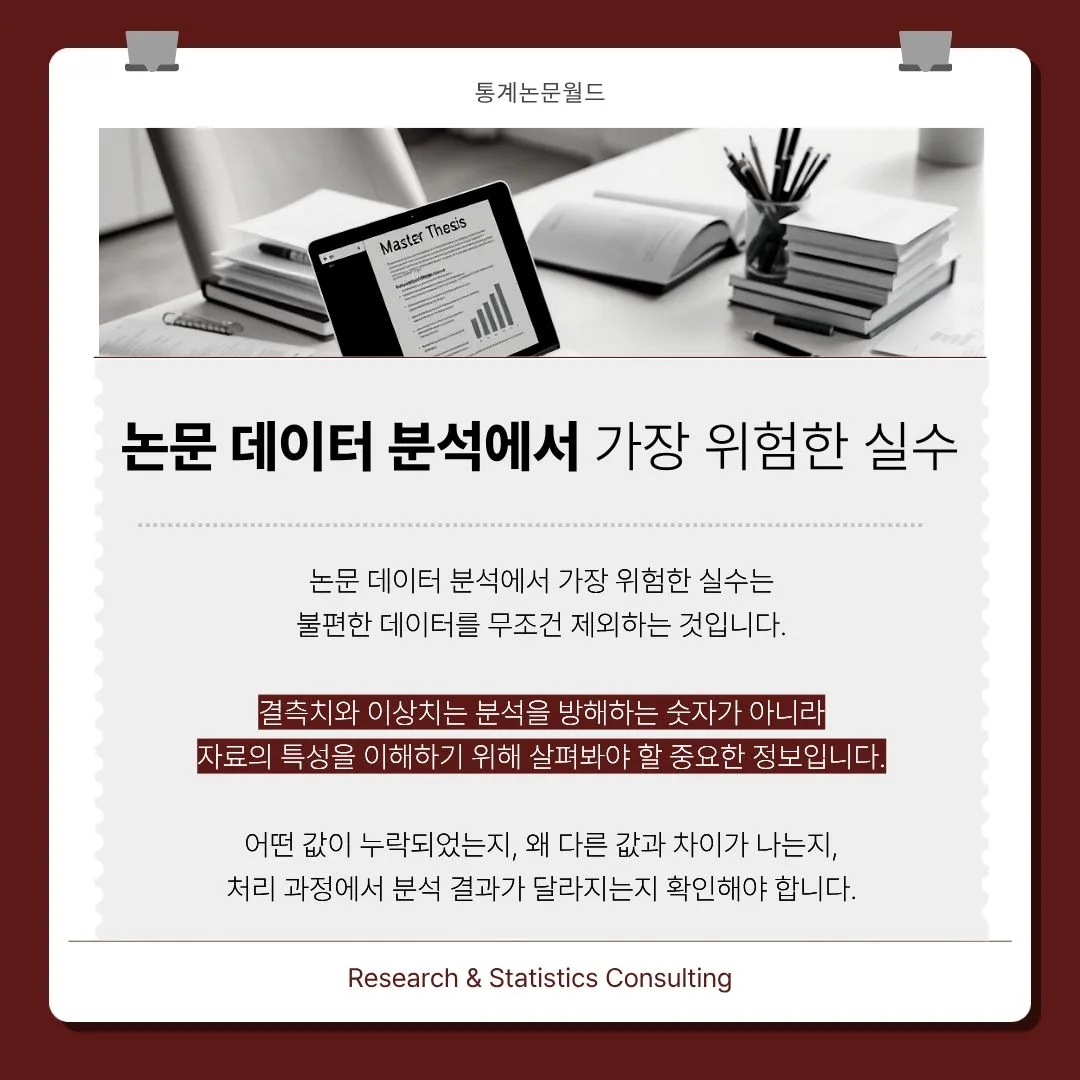
논문 데이터 분석에서
가장 위험한 실수는
불편한 데이터를 무조건
제외하는 것입니다.
결측치와 이상치는
분석을 방해하는 숫자가 아니라
자료의 특성을 이해하기 위해
살펴봐야 할 중요한 정보입니다.
어떤 값이 누락되었는지,
왜 다른 값과 차이가 나는지,
처리 과정에서 분석 결과가
달라지는지 확인해야 합니다.
데이터를 수집한 뒤
정제와 전처리 과정에서
판단이 어렵다면
통계논문월드의 전문 컨설팅을 통해
연구에 적합한 데이터 처리와
분석 방법을 상담해 보시기 바랍니다.
